Si estás harto de que las suscripciones mensuales te vacíen la cartera o de que los límites de tokens te corten el rollo justo cuando estás en el mejor momento de programación, no estás solo. Montar tu propio entorno de IA local es la solución definitiva para recuperar el control, proteger tu código y dejar de depender de los caprichos de los servidores en la nube.
Para quienes se están lanzando a esto, especialmente con máquinas potentes como los nuevos Mac mini M4, el ecosistema puede parecer un laberinto. Sin embargo, la clave está en entender que no necesitas una sola herramienta mágica, sino ensamblar un stack compuesto por un motor de inferencia, un modelo especializado en código y una interfaz que actúe como agente autónomo.
Los pilares de un asistente de código local
Para que todo funcione sin tener que copiar y pegar trozos de código como un loco, necesitas cuatro capas bien definidas. Primero está el runtime o entorno de ejecución, donde Ollama y LM Studio reinan actualmente por su sencillez para servir modelos mediante APIs compatibles con OpenAI. Luego viene el modelo de lenguaje (LLM), que es el cerebro que razona; aquí, la familia Qwen2.5-Coder se ha convertido en el estándar de oro por su equilibrio entre tamaño y capacidad.
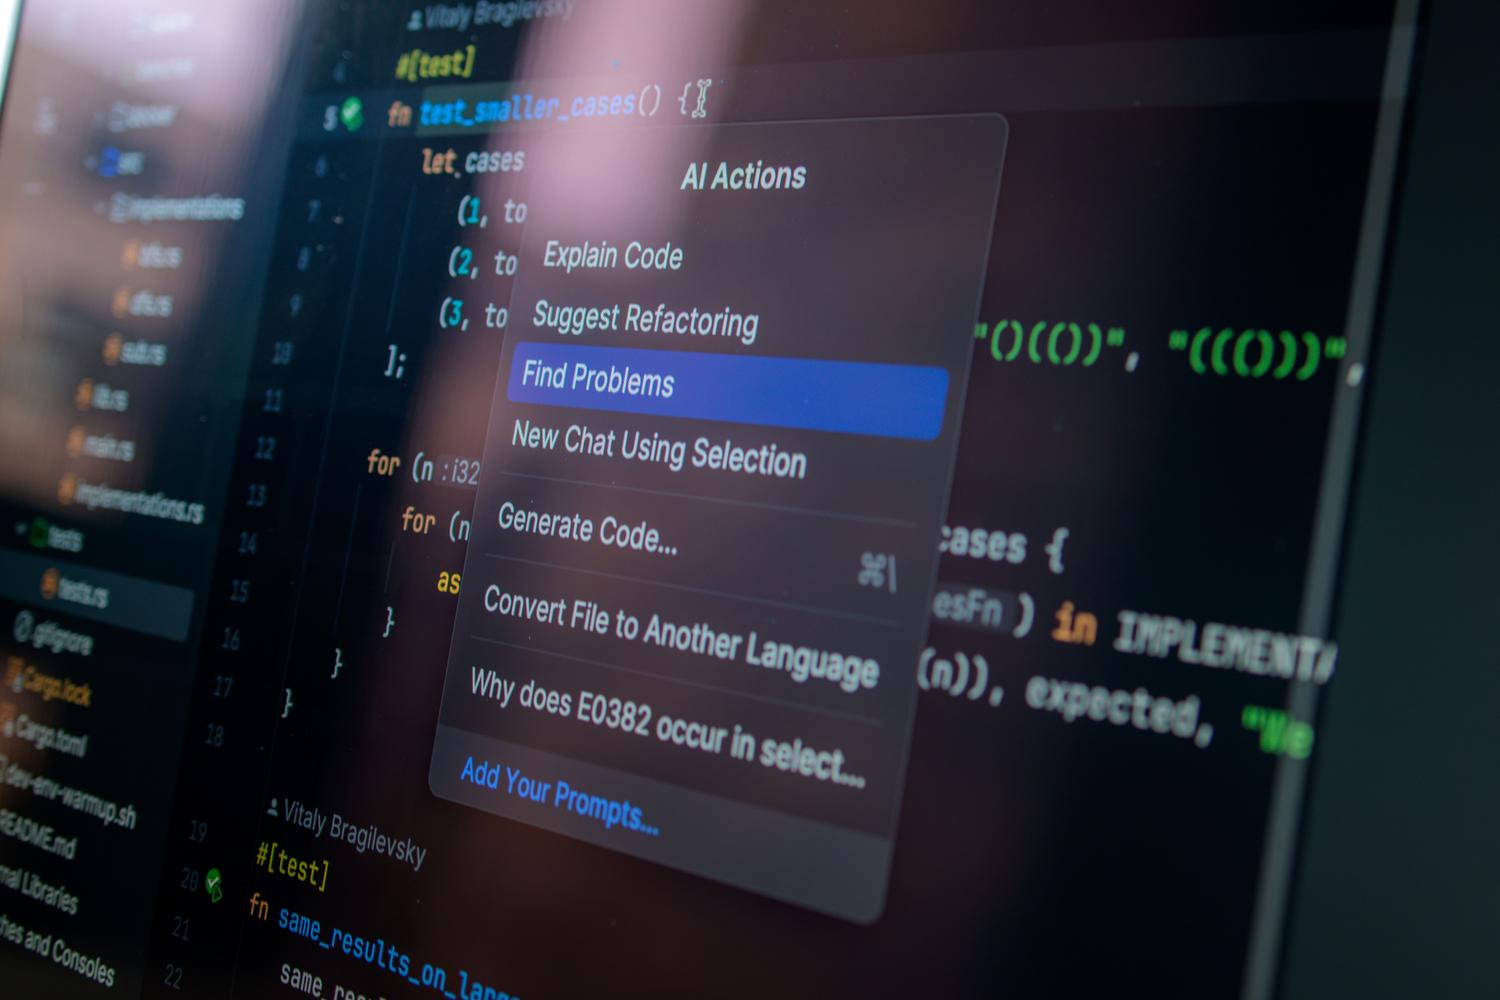
La tercera pieza es el cliente o interfaz de IDE, como la extensión Continue para VS Code, que te da el autocompletado y el chat integrado. Finalmente, existen los agentes de acción, que son herramientas más avanzadas como Cline o Aider, capaces de leer archivos completos, ejecutar comandos en la terminal y proponer cambios reales en el repositorio bajo tu supervisión.
Modelos recomendados según tu hardware
No todos los modelos caben en cualquier máquina. La regla de oro es que la memoria unificada o VRAM es el cuello de botella real, mucho más que la potencia bruta del procesador. Si tienes un equipo básico con 16GB de RAM, los modelos de 7B o 8B parámetros son tu mejor opción para tareas rápidas y chat ligero.
- Qwen2.5-Coder 1.5B: Ideal para el autocompletado instantáneo (tab-autocomplete) sin que el ordenador se ahogue.
- Qwen2.5-Coder 7B/14B: El punto dulce para quienes buscan un equilibrio entre velocidad y razonamiento lógico.
- Qwen2.5-Coder 32B: Para quienes tienen 24GB de VRAM o más y necesitan un coding serio y profesional que roce la calidad de modelos comerciales.
- DeepSeek-Coder-V2 Lite: Una alternativa brutal para tareas de lógica pesada o algoritmos complejos.
Herramientas y Agentes: ¿Cuál elegir?
Dependiendo de cuánta autonomía quieras darle a la IA, tienes varias rutas. Si prefieres algo integrado en el editor, Continue es la puerta de entrada perfecta. Si buscas un agente que se encarge de editar varios archivos y gestionar commits de Git automáticamente, Aider es la herramienta de poder por excelencia en la terminal, ya que optimiza el uso de tokens mediante mapas del repositorio.
Por otro lado, tenemos a Goose, un agente de código abierto muy versátil que puede interactuar con el sistema de archivos y extenderse mediante servidores MCP. Para quienes buscan algo más visual, AnythingLLM permite gestionar el conocimiento local e indexar documentos, aunque es más un agente de productividad que un desarrollador puro. También existen proyectos emergentes como OllamaCode, que se centran en que la IA no solo escriba el código, sino que sea capaz de ejecutarlo y probarlo en tiempo real.
Configuración paso a paso para un flujo eficiente
Para dejarlo todo niquelado, lo ideal es empezar instalando Ollama y bajando el modelo que mejor se adapte a tu memoria (por ejemplo, ollama pull qwen2.5-coder:14b). Una vez que el modelo responda bien en la consola, lo conectamos a VS Code mediante la extensión Continue, configurando la URL de localhost para que el chat y las ediciones ocurran en tu propia máquina.
Si quieres subir de nivel, puedes instalar Cline para tener un agente que proponga cambios en el shell y archivos, siempre pidiéndote permiso antes de ejecutar nada. Para un flujo de trabajo más robusto, usar Aider te permitirá realizar refactorizaciones multi-archivo con una precisión asombrosa, aprovechando que el agente entiende la estructura de tu Git.
Privacidad, costes y rendimiento
La gran ventaja de este camino es la privacidad absoluta; tus secretos industriales y claves API no viajan a ningún servidor externo, lo cual es vital si trabajas en sectores regulados. Además, una vez que has invertido en el hardware, el coste por token es literalmente cero, eliminando la frustración de los límites de uso de las versiones Pro de la nube.
En cuanto al rendimiento, la latencia cae drásticamente al no haber viajes de ida y vuelta por la red. Sin embargo, hay que tener cuidado con el KV cache; si notas que la IA se vuelve lenta de repente, probablemente te has quedado sin VRAM y el sistema está usando la RAM normal, que es mucho más lenta. La solución es reducir el tamaño del contexto o usar un modelo más pequeño.
Consejos para no romper el proyecto
Darle las llaves de tu terminal a una IA puede ser peligroso si no hay supervisión. Lo más inteligente es aplicar un principio de permisos restrictivos: deja que la IA lea los archivos primero, luego que proponga el plan y, solo al final, que escriba los cambios. Nunca permitas que un agente ejecute comandos de borrado o instalaciones masivas sin que hayas revisado el comando exacto.
Es recomendable trabajar en ramas de Git dedicadas para las pruebas de la IA. Así, si el agente decide hacer un refactor que rompe todo el proyecto, puedes volver atrás con un solo comando. El hábito ganador es: objetivo pequeño, inspección de contexto, aprobación de un parche limitado y validación con tests reales antes de hacer el commit final.
La combinación de un runtime como Ollama, modelos potentes de la serie Qwen y agentes autónomos como Aider o Cline transforma un ordenador personal en una estación de desarrollo autónoma. Al priorizar la memoria unificada y gestionar los permisos de ejecución, cualquier programador puede eliminar la dependencia de las cuotas de la nube y disfrutar de un flujo de trabajo fluido, privado y totalmente gratuito.