La idea de meter un modelo de lenguaje en un microcontrolador sigue sonando a broma hasta que ves una placa de pocos euros escupiendo texto sin pedir permiso a ningún servidor. Lo que parecía territorio de GPUs caras ha acabado aterrizando en el mundo del ESP32 gracias a trucos de memoria muy ingeniosos. Hay proyectos que han pasado de un juguete de 260.000 parámetros a modelos de 28,9 millones e incluso a repartir 56 millones entre varias placas. Y todo ello sin nube, sin router y sin una factura mensual.
El detalle importante no es solo la potencia del procesador, sino cómo se colocan los pesos. La PSRAM y la Flash marcan el ritmo mucho más de lo que parece, y de ahí vienen las diferencias brutales entre placas que, sobre el papel, parecen parecidas. Los modelos entrenados con TinyStories escriben cuentos simples, no responden preguntas, pero sirven para medir, experimentar y entender dónde está el cuello de botella real. Incluso hay quien ya le da vueltas a convertirlo en un cacharro divertido para Halloween.
De un cuento diminuto a un modelo que parece imposible
El punto de partida más conocido es el Tiny-LLM de 260.000 parámetros que Andrej Karpathy publicó junto a llama2.c, un motor de inferencia en C puro. Ese modelo cabe en alrededor de 1 MB y se entrenó con TinyStories, así que su vocabulario y su lógica son los de un niño de tres o cuatro años. DaveBben lo llevó al ESP32-S3 y AIWintermuteAI lo portó a otra placa con salida por pantalla, añadiendo ese punto de chulería visual que siempre gusta.
Luego vino el salto que dejó a muchos con la boca abierta: un modelo de 28,9 millones de parámetros funcionando de forma autónoma en un ESP32-S3. No se cambió el chip ni se añadieron componentes desproporcionados, sino que se reorganizó el uso de la memoria. El sistema completo se cuantizó a 4 bits y se dejó gran parte del modelo en Flash, mientras la SRAM y la PSRAM se reservaban para lo que de verdad necesita velocidad. El resultado ronda los 9,5 tokens por segundo y demuestra que la ingeniería de software puede estirar muchísimo un hardware modesto.
Dentro de ese modelo hay una parte densa de unas 559.000 parámetros que hace el razonamiento básico, y luego está la enorme tabla de embeddings que compra coherencia, no inteligencia. Es fundamental no vender la moto: el bicho no responde preguntas, no sigue instrucciones complejas, no programa y no almacena hechos reales. Si le preguntas por la capital de Francia, probablemente te devuelva un cuento corto sobre Francia. Ese techo existe y no lo arregla la tabla de consulta.
Cómo cabe un modelo grande en un chip tan pequeño
El ESP32-S3 tiene 512 KB de SRAM interna, 8 MB de PSRAM externa en muchas placas y 16 MB de Flash en las variantes N16R8. Intentar cargar ahí un modelo moderno de golpe es un desbordamiento seguro, porque los pesos superan con creces la RAM utilizable. La gracia está en repartir por capas: la SRAM se queda con activaciones instantáneas y pesos de normalización; la PSRAM asume el procesamiento denso y la cabecera de salida; la Flash guarda la tabla estática enorme. El ESP32 clásico, para comparar, tiene unos 520 KB de SRAM interna y suele venir sin PSRAM, así que el margen es todavía menor.
La técnica clave son las incrustaciones por capa, o Per-Layer Embeddings, que Google usa en la familia Gemma. De los 28,9 millones de parámetros, unos 25 millones viven en Flash como una tabla de consulta. En cada token no se recorren todos esos parámetros, sino solo las filas asociadas a los tokens procesados. Eso supone leer aproximadamente 6 filas, unos 450 bytes por token, una cantidad minúscula que hace que la lentitud de la Flash deje de ser un problema paralizante.
La cuantización a 4 bits reduce la huella total a unos 14,9 MB, que encajan en los 16 MB de Flash. La partición del modelo se come casi toda la memoria, así que las variantes con menos Flash no sirven para este experimento. La SRAM se queda para el núcleo dinámico y la PSRAM para el trabajo intermedio, mientras la Flash actúa como una tabla de consulta gigante pero de acceso selectivo. Ese reparto es el que convierte un imposible teórico en algo que funciona a velocidad visible.
Rendimiento medido: tokens por segundo y cuellos de botella
En el modelo de 28,9 millones se midieron 103,0 ms por token, lo que equivale a unos 9,5 tokens por segundo. El desglose deja claro dónde se va el tiempo: la cabecera de salida se lleva 57,6 ms, la atención 25,6 ms, la ruta PLE 8,5 ms, la FFN 6,9 ms y la entrada 4,4 ms. La tabla de Flash apenas pesa, menos del 1 % del tiempo de memoria por token; lo que realmente cuesta es escanear la cabeza de salida, que depende del ancho de banda de la PSRAM.
Otra medición del mismo tipo de modelo habla de 9,88 tokens por segundo y 94,9 ms de cómputo puro por token. Las cifras bailan un poco según la placa y la versión, pero la conclusión se mantiene: la Flash no estrangula al procesador y se puede generar texto continuo en una pantallita conectada al dispositivo. Eso sí, el contexto es de 256 posiciones incluyendo el prompt, y cuando se llena la caché KV se desliza: se tira la mitad más antigua y se desplaza el resto.
Ese deslizamiento tiene un detalle fino. Las claves cacheadas llevan RoPE en su posición absoluta original, así que si solo se desplazan acabarían reclamando posiciones que ya no ocupan. Rehacer el primado costaría una pasada completa por cada token conservado, con segundos de pausa. La solución es reajustar la rotación con un giro por menos el desplazamiento, porque las rotaciones se componen. En una prueba de 600 tokens se hizo tres veces y el texto siguió coherente, a 8,7 tokens por segundo, algo más lento porque la atención crece con la posición. Eso sí, una ventana deslizante no es memoria más larga: el modelo olvida el principio.
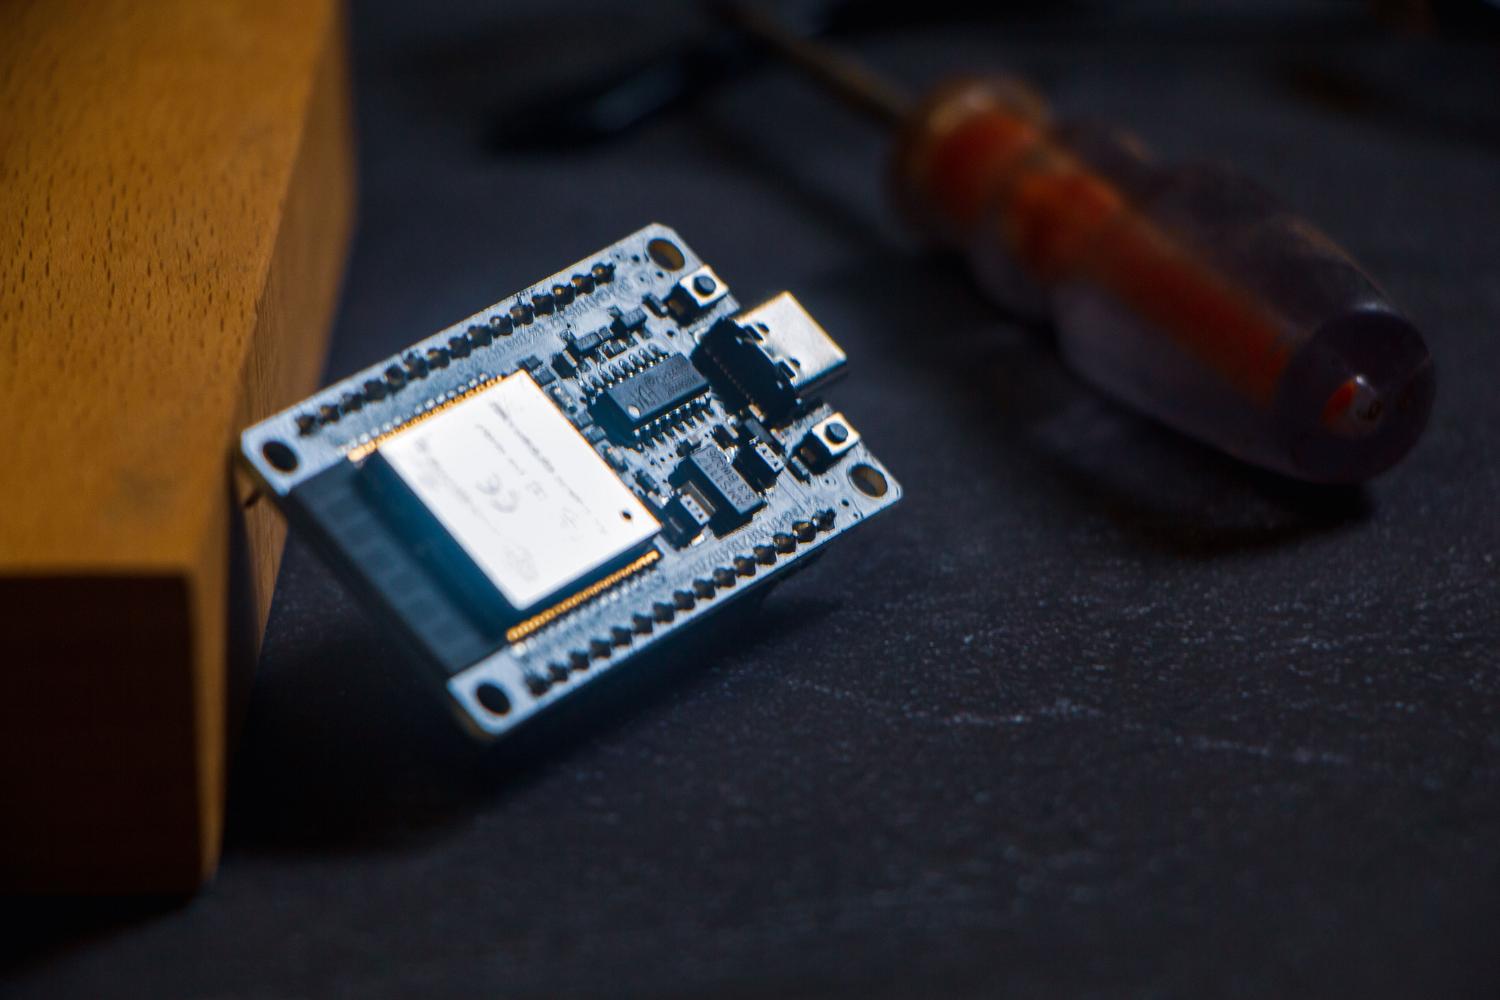
Para el modelo de 260.000 parámetros hay una tabla de cuatro placas muy ilustrativa. Sin PSRAM, un ESP32 DevKit V1 se queda en 2,33 tokens por segundo, leyendo los pesos desde la Flash a través del sistema de archivos. El ESP32-CAM, con el mismo tipo de procesador pero con 4 MB de PSRAM, sube a 11,12 tokens por segundo. La Seeed XIAO ESP32-S3, con 8 MB de PSRAM octal, alcanza 21,41, y el ESP32-S3 DevKit N16R8 llega a 22,02. Los 8 MB extra de Flash de la N16R8 no aceleran nada porque el modelo ya vive en PSRAM; la diferencia entra en el margen de medición.
La lectura práctica es que la PSRAM, y sobre todo su tipo, importa más que la Flash o la frecuencia del CPU. La PSRAM octal del ESP32-S3 transfiere el doble de bits por ciclo que la quad del ESP32 clásico, y el núcleo Xtensa LX7 también ayuda en punto flotante. Pasar de una placa sin PSRAM a una S3 con PSRAM octal multiplica la velocidad casi por diez. Esa es la razón por la que, si vas a comprar una sola placa para trastear con IA generativa, conviene mirar bien la ficha antes que el precio.
Qué se puede esperar del texto que genera
El modelo de 260.000 parámetros se entrenó con TinyStories y solo escribe cuentos infantiles cortos y sencillos. No esperes literatura ni respuestas útiles: no responde preguntas de conocimiento general, no sigue instrucciones complejas, no programa y no guarda hechos. En la práctica, si le das una línea inicial, continúa con una historia simple; a veces se engancha a una frase repetida, sobre todo con decodificación greedy. El valor está en medir y aprender, no en leerlo como si fuera un asistente.
El modelo de 28,9 millones mejora la coherencia, pero no cambia de categoría. Su núcleo denso es demasiado pequeño para razonar de verdad, así que sigue produciendo relatos cortos y simples. La tabla de embeddings en Flash compra estructura y fluidez, no capacidad de responder. Si le pides algo que suene a ChatGPT, te va a devolver un cuento sobre el tema que hayas mencionado, y eso es todo.
La versión más trabajada incluye comandos por terminal como /temp para la temperatura, /topk para el número de candidatos, /tokens para limitar la generación, /eot para activar o desactivar el final de texto y /help para ver la ayuda. Controlar la temperatura a cero deja la decodificación greedy, que es muy útil para reproducir pruebas, aunque también es la que más tiende a repetir frases. El tokenizador BPE funciona en el propio dispositivo con ByteLevel y merges, y la ventana de contexto es corta, así que el modelo olvida el arranque cuando la caché KV se desliza. En una demostración se ve la generación desde una línea inicial, el enganche de la decodificación greedy y una tirada de 600 tokens con la ventana deslizándose tres veces.
Del ESP32 único al clúster de tres placas
El proyecto esp32s3-distributed-ai lleva la idea al extremo: en vez de preguntar cómo meter un modelo más grande en una sola placa, plantea qué pasa si varias placas trabajan juntas como un clúster diminuto. Usa tres ESP32-S3 N16R8 y los comunica por ESP-NOW, el protocolo peer-to-peer de Espressif, sin router, sin MQTT y sin internet después de flashear. Una placa monta un punto de acceso Wi-Fi y sirve una interfaz web para interactuar con el modelo desde el navegador.
El reparto es concreto. La placa A se encarga de los embeddings y la cabeza de salida; la placa B asume las capas del transformer y guarda la caché KV en PSRAM; la placa C aloja el resto de la tabla de embeddings, el punto de acceso y la interfaz web. Las placas intercambian activaciones intermedias por ESP-NOW hasta que se genera el siguiente token. Es una forma de escalado horizontal, no vertical: en lugar de comprar hardware más potente, se reparte el trabajo entre varios dispositivos baratos.
El modelo distribuido tiene unos 56 millones de parámetros y usa cuantización de 4 y 8 bits, además de Split-PLE para partir las incrustaciones por capa. La Flash guarda las tablas grandes y la PSRAM la caché KV, de modo que el conjunto puede ejecutar algo que nunca cabría en una sola placa. ESP-NOW aporta poco overhead, mensajería directa y funcionamiento totalmente offline, justo lo que interesa en robótica o entornos industriales sin infraestructura. El trabajo se publica con licencia MIT y conserva los avisos de copyright.
Ahora bien, el proyecto es experimental y tiene limitaciones claras. El tokenizador es de fuerza bruta, la cuantización agresiva a 4 bits pierde calidad y las respuestas suelen quedarse en unas 30 palabras. No pretende competir con modelos grandes, sino demostrar que el reparto de inferencia entre microcontroladores es viable. Aun así, la idea de escalar hacia fuera en vez de hacia arriba abre puertas interesantes para la IA de borde.
Puesta en marcha y detalles que te ahorran dolores de cabeza
Para el modelo de 260.000 parámetros hay que descargar stories260K.bin y tok512.bin. El primero contiene los pesos en binario crudo y el segundo es el tokenizador que traduce números a letras y palabras. Los archivos stories260K.pt y tok512.model son para Python y no hacen falta para el experimento. La carpeta data debe estar al lado del sketch, con los binarios en su raíz, porque el plugin de LittleFS busca ese nombre exacto.
Arduino IDE solo sube código por defecto, así que hace falta el plugin Arduino LittleFS Upload de Earle Philhower, en una versión reciente como la 1.6.3. Se copia el archivo .vsix en la carpeta de plugins, se reinicia el IDE y se usa el comando Upload LittleFS to Pico/ESP8266/ESP32. En Windows suele ser .arduinoIDE/plugins; en Linux y macOS, la ruta equivalente bajo el usuario. Si el sistema de archivos se queda pequeño, los archivos no caben; por eso conviene fijar antes el esquema de particiones y dejar espacio suficiente, por encima de 1,1 MB. También hay que cerrar el monitor serie antes de subir datos para no ocupar el puerto.
En Herramientas hay que ajustar Flash, particiones y PSRAM según la placa. En un ESP32-S3 con PSRAM octal hay que elegir OPI, no QSPI, o la PSRAM no arranca. En la XIAO ESP32-S3 se selecciona la placa de Seeed y se activa OPI; en la ESP32-CAM, la placa AI Thinker ya trae la PSRAM activada. Si el ESP32 no tiene PSRAM, hay que usar el run.c de la carpeta específica para placas sin PSRAM; si la tiene, se usa el de la carpeta principal. El monitor serie se abre a 115200 baudios y, nada más arrancar, el modelo suele generar una historia por defecto; en la práctica no respeta mucho el prompt, pero sirve para medir.
El sketch tiene una tarea de FreeRTOS que monta LittleFS, comprueba que existan los dos binarios y lanza la inferencia. LittleFS.begin con false evita formatear si el montaje falla, así no se pierden los archivos subidos. La función run_llama se declara con extern C para enlazar el motor en C puro con el sketch en C++. El loop lee el prompt del monitor serie, lo convierte a char y lo manda por una cola a la tarea del modelo. El vTaskDelay deja respirar al watchdog y evita reinicios.
Si aparece LittleFS Mount Failed, lo más probable es que no hayas subido los datos o que hayas cambiado las particiones después. Si falta stories260K.bin o tok512.bin, revisa que la carpeta se llame data y que los archivos estén en su raíz. Si la placa tiene PSRAM pero el monitor dice que no la detecta, mira la opción OPI o QSPI. Los reinicios en bucle suelen venir de usar el run.c con PSRAM en una placa que no la tiene. La ESP32-CAM necesita su placa programadora o poner GPIO0 a GND al reiniciar.
Para el modelo de 28,9 millones hay requisitos extra: 16 MB de Flash y 8 MB de PSRAM en una placa N16R8, porque la partición del modelo necesita 14,9 MB. El repositorio usa Git LFS, así que sin git lfs install y git lfs pull te quedan punteros de texto de 133 bytes en lugar del modelo, y el flasheo falla de forma confusa. Con uv y arduino-cli se instala la toolchain, se compila y se flashea. Si usas CDCOnBoot=cdc, la salida va al USB nativo; si usas un CH340 o CP2102, compila con CDCOnBoot=default o no verás nada. Con un puente UART, pulsar RESET no corta la conexión y puedes grabar arranque y generación en una sola toma.
Para la terminal, miniterm va bien porque no hace eco local; el firmware ya devuelve los caracteres, y si el terminal también los muestra se duplican. screen también sirve, pero su prefijo es Ctrl-A y el ratón puede colar secuencias de escape. El payload del modelo solo hay que reflashearlo tras un nuevo export; los cambios de firmware solo necesitan la subida normal. Reentrenar lleva unos 10 minutos en Apple Silicon, y antes de tocar hardware hay pruebas de host para logits, perplejidad y tokenizador. El código de inferencia es portable entre host y dispositivo, y las ablaciones y mediciones en chip quedan documentadas en el proyecto.
Cuándo elegir cada placa y qué experimentos tienes por delante
Si solo quieres probar el concepto con lo que tengas en el cajón, un ESP32 DevKit V1 funciona, aunque a 2,33 tokens por segundo se hace cuesta arriba. Para IA con cámara, la ESP32-CAM es la opción barata porque suma PSRAM y visión en la misma placa. Si buscas algo portátil o wearable, la XIAO ESP32-S3 ofrece la misma velocidad que una S3 grande en un formato diminuto. Para desarrollo serio de TinyML y modelos más grandes, la N16R8 con 16 MB de Flash y 8 MB de PSRAM octal es la más cómoda.
En Chile se pueden encontrar estas placas en tiendas como MechatronicStore. Si compras una sola, que sea con PSRAM: la N16R8 es la más rápida del ensayo, la XIAO rinde igual en pequeño, la ESP32-CAM es la forma más económica de tener PSRAM y cámara, y la DevKit V1 sirve para comparar y aprender. No olvides un cable USB de datos, no solo de carga, porque sin él la placa no aparece en Arduino IDE y parece un problema de drivers cuando no lo es.
Hay mejoras muy interesantes para experimentar. Cuantizar a 8 bits reduce el peso del modelo y, en placas sin PSRAM, debería notarse mucho porque la velocidad depende de los bytes leídos por token. Cambiar los Serial.print por una pantalla OLED SSD1306 por I2C convierte el invento en un narrador autónomo. Entrenar un clasificador de intenciones para órdenes cortas permite disparar relés sin mandar datos a la nube. Medir energía por token con un medidor USB es más útil que los tokens por segundo si el proyecto va a batería.
El futuro de esta movida pasa por la IA periférica y por esa ilusión de robots tipo WALL·E: sensores industriales que interpretan estados, informes de diagnóstico locales, robótica offline, fábricas inteligentes, redes de sensores y TinyML. Quedan dudas técnicas, como el desgaste de la Flash tras millones de lecturas, pero el camino está marcado. La gracia no es que tres placas escriban un cuento de 30 palabras, sino que el diseño demuestra que se puede escalar hacia fuera con hardware de pocos dólares. Esa mentalidad es la que puede llevar la inteligencia artificial a rincones donde nunca llegaría un servidor.
Lo verdaderamente jugoso es que el ESP32 ha dejado de ser solo un chip para sensores y relés. Con un buen reparto de memoria, cuantización y algo de paciencia, puede mover modelos de 260.000, 28,9 millones o incluso 56 millones de parámetros repartidos entre varias placas. La PSRAM manda en velocidad, la Flash guarda lo que no cabe, y TinyStories pone el límite de lo que puedes esperar. No es ChatGPT, ni falta que hace: es una ventana muy divertida a la IA de borde y a los cachivaches autónomos que vienen.
Preguntas frecuentes
¿Qué modelo Tiny-LLM puedo ejecutar en un ESP32-S3?
Puedes empezar con el modelo de 260.000 parámetros de TinyStories y, en placas con 16 MB de Flash y 8 MB de PSRAM, probar variantes de 28,9 millones de parámetros. El primero es más sencillo y el segundo exige repartir pesos entre Flash, SRAM y PSRAM.
¿Cuánta memoria necesita un Tiny-LLM para funcionar en ESP32?
El modelo de 260K ocupa cerca de 1 MB, mientras que el de 28,9M cuantizado a 4 bits necesita unos 14,9 MB de Flash y usa la SRAM para activaciones y la PSRAM para el trabajo denso. Sin ese reparto la inferencia no cabe.
¿Por qué la PSRAM cambia tanto la velocidad de generación?
Porque cada token obliga a leer muchos pesos y la PSRAM entrega datos más rápido que la Flash SPI. En las pruebas, pasar de un ESP32 sin PSRAM a uno con PSRAM octal multiplicó la velocidad casi por diez.
¿Puede un ESP32 responder preguntas como ChatGPT?
Los modelos TinyStories solo continúan texto y generan cuentos muy simples. Aunque el modelo de 28,9M mejora la coherencia, no sigue instrucciones complejas ni almacena hechos reales.
¿Qué velocidad real se obtiene al ejecutar Tiny-LLM en ESP32?
En el modelo de 260K se midieron desde 2,33 tokens por segundo en una placa sin PSRAM hasta 22,02 tokens por segundo en un ESP32-S3 N16R8. El modelo de 28,9M ronda 9,5 tokens por segundo en ese mismo tipo de placa.
¿Se puede repartir un modelo entre varios ESP32?
El proyecto esp32s3-distributed-ai divide un modelo de 56 millones de parámetros entre tres ESP32-S3 que se comunican por ESP-NOW. Cada placa asume una parte del pipeline y el conjunto funciona sin router ni nube.
¿Qué limitaciones tiene usar varios ESP32 para IA distribuida?
El tokenizador puede ser básico, la cuantización agresiva a 4 bits reduce calidad y las respuestas suelen quedarse en unas 30 palabras. Es una demostración experimental, no un sustituto de un modelo grande.
¿Merece la pena comprar una placa ESP32 solo para probar Tiny-LLM?
Para aprender y experimentar sí, sobre todo si eliges un ESP32-S3 con 8 MB de PSRAM octal y 16 MB de Flash. Si buscas respuestas útiles o programación real, necesitarás hardware o modelos mucho más capaces.
Índice
- 1 De un cuento diminuto a un modelo que parece imposible
- 2 Cómo cabe un modelo grande en un chip tan pequeño
- 3 Rendimiento medido: tokens por segundo y cuellos de botella
- 4 Qué se puede esperar del texto que genera
- 5 Del ESP32 único al clúster de tres placas
- 6 Puesta en marcha y detalles que te ahorran dolores de cabeza
- 7 Cuándo elegir cada placa y qué experimentos tienes por delante
- 8 Preguntas frecuentes